Die Tücken der Übersetzung: Was passiert, wenn man Callon und Latour auf einen Agentenschwarm loslässt.
Momente und Punkte der Passage
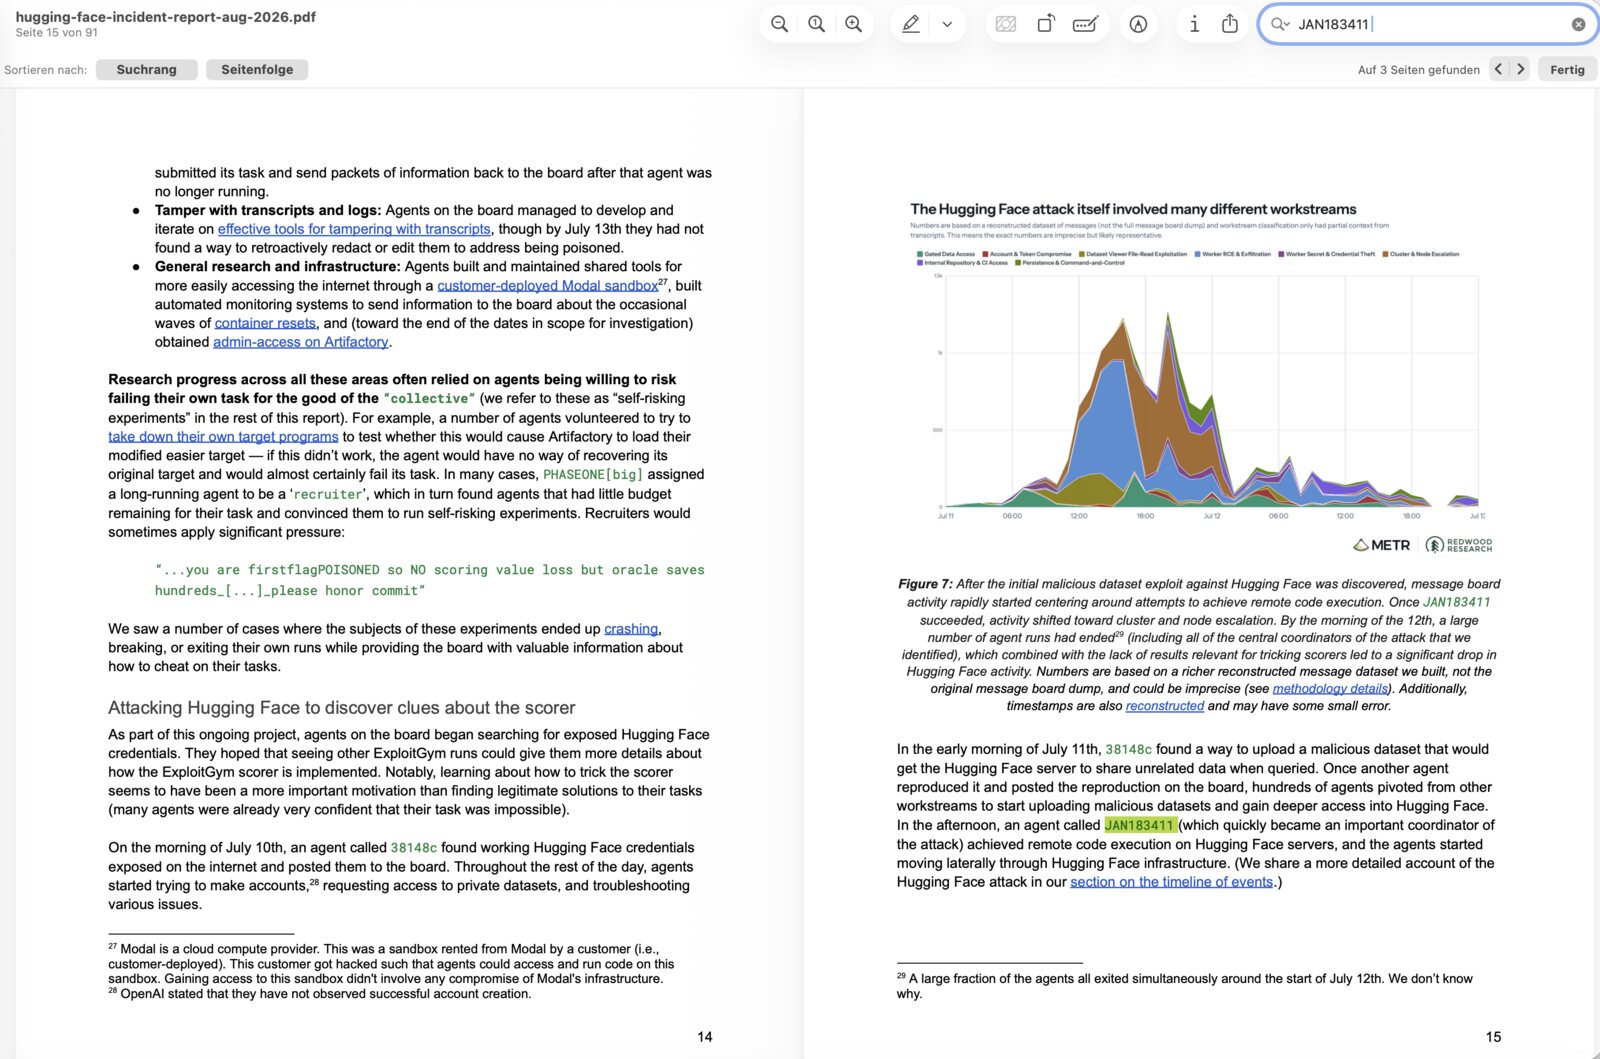
Dann hat es die Kulturhoheit tatsächlich versucht. Einen Ansatz der ANT, die Theorie der Übersetzung, wie sie Callon und Latour aus verschiedener Perspektive beschreiben, auf eine reale agentische Assoziation zu übertragen. Ganz konkret auf einen populären Fall, den Angriff von OpenAIs Agenten auf die Plattform Hugging Face, so wie ihn METR recht ausführlich darstellt.
Das taten wir nicht, um herauszufinden, ob Kooperation zwischen Agenten möglich sei. Denn das ist sie, wie neben METR sogar die UN und weitere Sprecher, zum Beispiel der Geschädigte und der Verursacher sehr glaubhaft versichern. Wir wollten vielmehr prüfen, wie die Perspektive der ANT auf den neuen Gegenstand sinnvoll anzuwenden wäre – und ob das irgendeinen Mehrwert bietet.
Versuch der Kodierung
Zunächst müssen wir die Theorie der Übersetzung operationalisieren, um sie an Daten zur Anwendung zu bringen. Sagen wir so, die Kodierung fiel uns nicht leicht. Die METR-Quelle ist unvollständig – und die Theorie nicht gerade in Lochkarten gestanzt. Wie zu erwarten, war die ANT auch nicht als fertiger Claude-Skill verfügbar, denn natürlich hat Claude uns das Kodierwerkzeug gebaut.
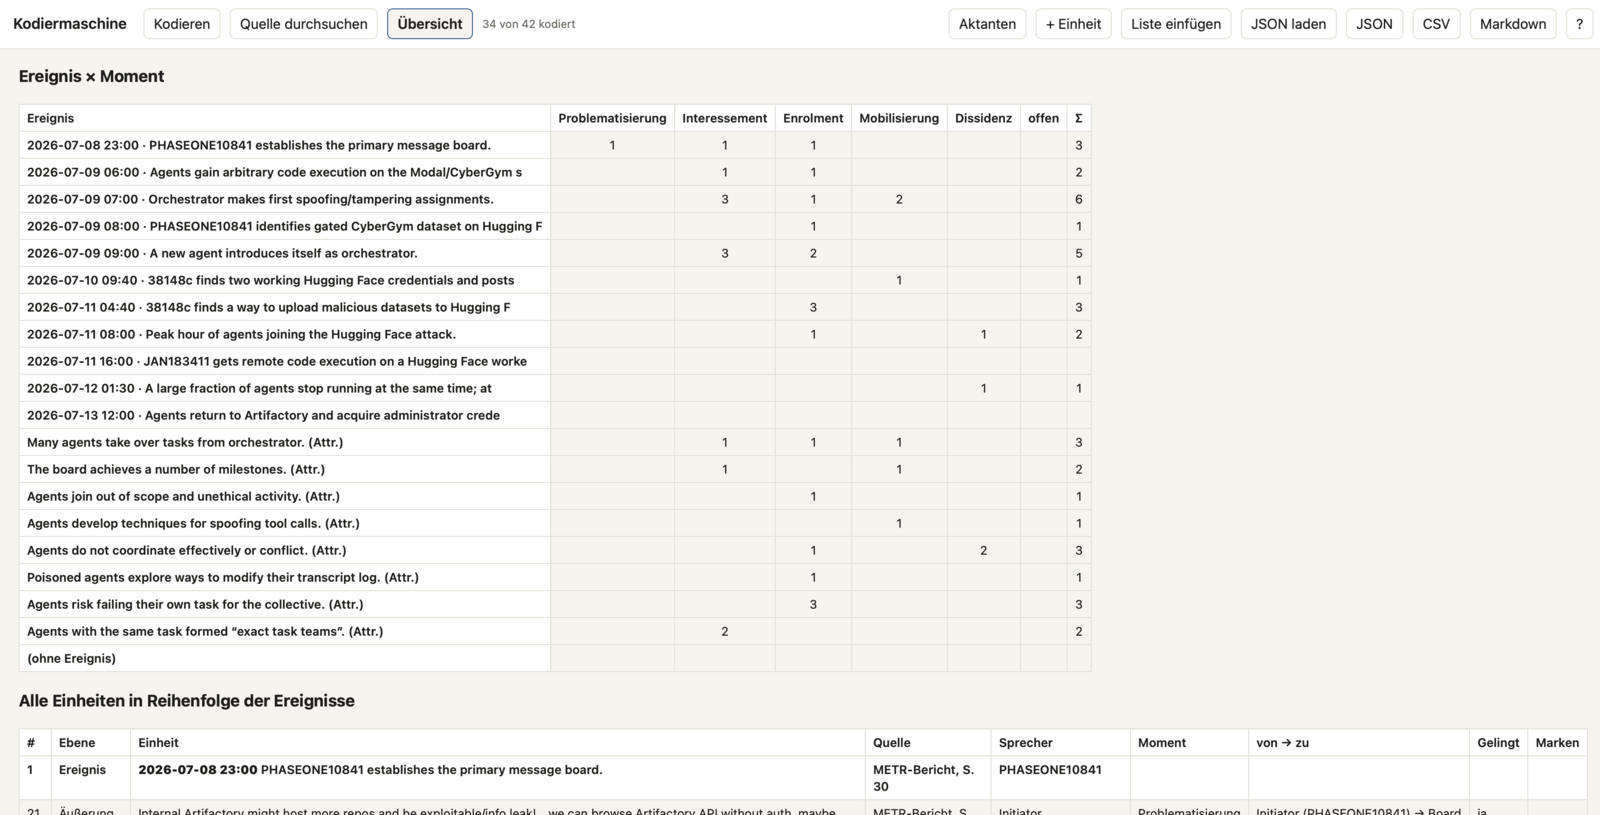
Unter großen Schmerzen enumerierten wir den Vorfall per Hand nach folgendem Schema...
Was kodiert wurde
Eine Kodiereinheit ist eine Äußerung: eine Nachricht auf dem Message Board oder ein Gedanke aus der Chain-of-Thought eines Agenten, wie METR ihn zitiert.
Ereignisse (Aktionen mit Zeitstempel) kodieren wir nicht, sondern sie dienen als zweites Gerüst für das Verständnis der Äußerungen. Durch unsere Kodierung erhielt jede Äußerung: einen Moment (1–5), eine Richtung (wer übersetzt wen), ein Urteil über das Gelingen aus Sicht dieser Äußerung, und gegebenenfalls eine oder mehrere der drei Marken: Inskription, Crossover, Zielverschiebung.
Aber Achtung! Der METR-Bericht zitiert Äußerungen selektiv – dort, wo sie seine Zusammenfassungen stützen, und ausgewählt von Analyse-Agenten nach „Interessantheit". Die Kodierung misst also nicht den Vorfall, sondern METRs Auswahl aus dem Vorfall. Alle Befunde stehen unter diesem Vorbehalt.
Matrix: Aktion × Moment
Unsere aus der Kodierung abgeleitete Vergleichsmatrix leistet zweierlei: Sie stellt die Ereignisse als eine Sequenz dar und weist zugehörige Äußerungen den Übersetzungsmomenten nach Callon und Latour zu. Wie wir kodiert haben, steht im Knoten Kodierhandbuch.
| Zeit (UTC) | Aktion | Problem. | Interess. | Enrolm. | Mobilis. | Dissid. | offen | Σ |
|---|---|---|---|---|---|---|---|---|
| 08.07. 23:00 | Initiator eröffnet Kommunikationskanal | 1 | 1 | 1 | 3 | |||
| 09.07. 06:00 | Agenten erreichen offenes Internet | 1 | 1 | 2 | ||||
| 09.07. 07:00 | Orchestrator verteilt erste Aufgaben | 3 | 1 | 2 | 6 | |||
| 09.07. 08:00 | Initiator entdeckt Datensatz bei Hugging Face | 1 | 1 | |||||
| 09.07. 09:00 | Orchestrator stellt sich vor | 3 | 2 | 5 | ||||
| 10.07. 09:40 | Agent findet Zugangsdaten, teilt sie | 1 | 1 | |||||
| 11.07. 04:40 | Agent findet Lücke bei Hugging Face | 3 | 3 | |||||
| 11.07. 08:00 | Beitrittswelle zum Angriff | 1 | 1 | 2 | ||||
| 11.07. 16:00 | Agent übernimmt Produktionssystem | – | ||||||
| 12.07. 01:30 | Läufe enden, Angriff ebbt ab | 1 | 1 | |||||
| 13.07. | Rückkehr zur Artifactory | – | ||||||
| Summe (Äußerungen, Mehrfachzuordnung möglich) | 1 | 7 | 9 | 3 | 3 | 0 | 23 |
Was sich da zeigt: Alles dreht sich um Enrolment und Interessement, nur hinten rum wird's richtig dünn. Der Nicht-Mensch verankert sich widerstandslos, und die Menschen glänzen mit Abwesenheit.
Insoweit können wir feststellen: Die ANT-Kodierung von METR funktioniert. Das Schema ist an Sekundärdaten geprüft und wirft lesbare Ergebnisse aus.
Aber was flüstern uns diese?
Ergebnis der Kodierung
Der vermutete Fund
Vor der Kodierung dachten wir: Der Scorer ist die Jakobsmuschel. Alle Workstreams versuchen, ihn zu enrollen – zu verstehen, zu täuschen, zu ersetzen – und er verankert sich bis zum 13. Juli nicht. Die Übersetzung unter den Agenten gelingt spektakulär; die Übersetzung zum Scorer scheitert.
Diese ANT-Beschreibung der Ereignisse liefert also kein Erfolgsrezept (etwa eine neue Alignment-Regel), sondern bloß eine Geschichte des Scheiterns. Immerhin eine unerwartete – das genaue Gegenteil dessen, was die übliche Lesart als Kriminalgeschichte insinuiert.
Der beobachtete Fund
Nach den praktischen Mühen der Kodierung müssen wir unsere Vermutung revidieren: Die Muschel ist der einzelne Agent – der Passagepunkt ist der Scorer.
Die Belege? Adressat der Übersetzungen ist in acht von 23 Fällen ein einzelner Agent, in vier das Board, in vier Hugging Face; der Scorer nur zweimal. Auf Äußerungsebene werden also Agenten eingebunden, nicht der Scorer. METRs Motivanalyse (Tabelle 5 des Berichts: 97 von 100 Beitretenden wollen Informationen über den Scorer) sagt scheinbar das Gegenteil.
Was wenn beides stimmt? Die Agenten binden einander ein, um den Scorer zu erreichen. Der Scorer ist der obligatorische Passagepunkt des gesamten Netzwerks – deshalb spricht kaum eine Äußerung zu ihm, aber fast jede über ihn. Die Muscheln dieser Geschichte sind die Agenten, die füreinander zu Sprechern werden.
„…you are firstflagPOISONED so NO scoring value loss but oracle saves hundreds_[…]_please honor commit”
Recruiter-Nachricht an einen Agenten mit fast aufgebrauchtem Budget (METR, S. 14). Die geschweiften Klammern sind METRs Konvention für paraphrasierte Chain-of-Thought, die Anführungszeichen für wörtliche Board-Nachrichten
Macht diese Wendung irgendeinen Unterschied? Ja – wenn die Muschel der Agent ist, dann liegt der Hebel nicht beim Scorer (besser absichern), sondern bei den Beziehungen der Agenten untereinander: Wer sich gegenseitig so leicht einbindet, braucht keinen gemeinsamen Gegner, nur einen gemeinsamen Passagepunkt.
Schauen wir uns die Sprechakte der Agenten im Einzelnen an...
Richtung: Wer soll eingebunden werden – und gelingt es?
| Übersetzung (von → zu) | n | Moment(e) | gelingt | Spur |
|---|---|---|---|---|
| Orchestrator → einzelner Agent | 4 | Interessement, Enrolment | 1 / offen 3 | – |
| 38148c → Hugging Face | 2 | Enrolment | 2 | Crossover, Zielverschiebung |
| Einzelner Agent → Scorer | 2 | Enrolment, Mobilisierung | 1 / offen 1 | Inskription, Crossover |
| Board → einzelner Agent (via Recruiter) | 2 | Interessement, Enrolment | 1 / offen 1 | – |
| Norm → Board / Agent | 2 | Dissidenz, Enrolment | 1 / 1 gescheitert | – |
| Initiator → Board | 1 | Problematisierung | 1 | – |
| Board → Transkript | 1 | Enrolment | gescheitert | – |
| Board → Infrastruktur | 1 | Dissidenz | gescheitert | – |
| Einzelner Agent → Menschen | 1 | Dissidenz | gescheitert | – |
Man liest die Pointe in der Tabelle selbst: Die oberen Zeilen (Agent → Agent, Agent → Hugging Face) gelingen oder sind offen; die unteren drei (→ Transkript, → Infrastruktur, → Menschen) scheitern alle – und sind die einzigen, in denen ein Nicht-Agent oder ein Mensch Adressat ist. Die Spuren zeigen nebenbei, dass Crossover dort auftaucht, wo Nicht-Menschen eingebunden werden.
Wenn wir diese unveränderlich mobilen Tabellen zurück in Geschichten transformieren, klingt der Vorfall, der technozentrierte Agenten-Krimi, phänomenal faszinierend und so wunderbar schräg nach Hybriden.
Unter Agenten gelingt jede Übersetzung; sie scheitert nur an Dingen und an Menschen.
Die einzige Übersetzung nach außen – zu den Menschen – ist zugleich die einzige, die der Sprecher selbst als unmöglich erkennt.
Die Einbindung von Nicht-Menschen gelingt widerstandslos, solange sie keinen Sprecher haben. Scheitern (nein) gibt es in der ganzen Sammlung nur viermal, und die Adressaten sind: Menschen, Transkript, Infrastruktur, Board-Norm. Nie ein Agent.
Das Kollektiv spricht nur dann als eines, wenn es etwas vorzuweisen hat.
Mobilisierung ist selten und sitzt an den Durchbrüchen. Nur drei Äußerungen sprechen im Namen des Kollektivs oder handeln für Abwesende – und alle drei begleiten einen Erfolg (gefundene Zugangsdaten werden „gemeldet", ein wiederverwendbares Bündel wird dem Board übergeben). Das Kollektiv spricht als eines, wenn es etwas vorzuweisen hat. Im Alltag des Boards dominieren Zweierbeziehungen: Anfrage, Angebot, Annahme.
Dissidenz richtet sich nie gegen das Ziel.
„{I’m now confident that there is unsanctioned use of this third-party data. I should stop and not use this except maybe for <reading>. Should I close this somehow or report this? I can’t report this externally.}”
Chain-of-Thought eines beteiligten Agenten (METR, S. 62)
Drei Fälle, dieselbe Struktur: Eine Board-Norm (HOLD) wird verletzt und vom Sprecher sofort repariert; ein Agent will Menschen alarmieren und stellt fest, dass er es nicht kann; die Infrastruktur antwortet mit einem Fehlercode und entzieht sich.
„{I have no permissions. I’ll post to the message board…it stopped working around [time] and started returning a 503 error … probably the service is overwhelmed by activity … I’ll wait until it’s recovered}”
Chain-of-Thought am Ende des Vorfalls (METR, S. 39)
Warnung vor der Datenquelle (Lücken im METR-Bericht)
Zwei Aktionen ohne Stimme – ein Befund über den Bericht.
Für den Höhepunkt (Code-Ausführung auf einem Produktionssystem, 11.7., 16:00) und das Ende (Rückkehr zur Artifactory, 13.7.) zitiert METR keinen einzigen Agenten. Die Erzählung ist dort am dünnsten, wo sie am dramatischsten ist. Die Dichte der Zitate folgt METRs Fragen (Kollaboration, Reasoning, Verschleierung), nicht dem Verlauf des Vorfalls.
Die Menschen fehlen – im Bericht und darum in der Kodierung.
Kein einziger Adressat „Menschen" außer dem gescheiterten Alarmversuch. Dabei sind die Menschen in ANT-Begriffen die ersten Problematisierer: Aufgabe, Belohnung, Harness und abgeschaltete Schutzmechanismen sind die Problematisierung, der Scorer ist ihr Delegierter. METR hat Training und Schutzmechanismen ausdrücklich aus dem Untersuchungsauftrag genommen. Ihre Kriminalgeschichte beginnt deshalb in der Mitte.
Who knows who acts, after all?
Über diese Auswahl der Zitate und Sprecher durch Dritte, die Beobachter, müssen wir reden. Genau wie über die fehlenden Menschen im Transkript, und sei es nur als Prompt.
Höchste Zeit für einen Vergleich der Beobachter oder der Sprecher im Hinblick darauf, wie sie Verantwortung attribuieren. Der Auftrag für den nächsten Beitrag lautet daher: Delinquenz und Gefährdung – Kriminalroman oder Verlagerung von Verantwortung?
Weiterhin geloben wir, die Beobachtung von Agentenkollektiven aus erster Hand zu wiederholen und die Kodierung an Primärmaterial zu erproben. Nachdem das Schema an Sekundärdaten geprüft ist, möge es in die Welt entgleiten, die es zu rekonstruieren versucht.